Nie istnieje żadna liczba, którą można podać bez znajomości trzech rzeczy: jakiej wielkości efekt chcesz wykryć, przy jakiej mocy i przy jakim poziomie istotności. Wszystkie krążące po forach „minimum 100 ankiet” i „na licencjat wystarczy 50” są zgadywaniem. Ten tekst pokazuje, jak policzyć liczbę zamiast ją zgadywać, i jak zapisać uzasadnienie, które obroni się przed komisją.
Rozróżnienie jest jedno i porządkuje całą resztę: badanie ilościowe wymaga obliczenia liczebności, badanie jakościowe wymaga uzasadnienia nasycenia. To dwie różne procedury i nie wolno ich mieszać.
Trzy parametry, od których wszystko zależy
Analiza mocy — czyli formalna procedura obliczania wymaganego N — działa na czterech powiązanych wielkościach: poziomie istotności, mocy testu, wielkości efektu i liczebności próby. Znając trzy z nich, obliczasz czwartą. W planowaniu badania znane są trzy pierwsze, a szukane jest N; to jest tak zwana analiza a priori.
| Parametr | Co oznacza | Typowo przyjmowana wartość | Wpływ na wymagane N |
|---|---|---|---|
| Poziom istotności α | Ryzyko uznania efektu, którego nie ma | 0,05 | Im mniejsze α, tym większe N |
| Moc testu (1 − β) | Szansa wykrycia efektu, który istnieje | 0,80 | Im wyższa moc, tym większe N |
| Wielkość efektu | Jak duża jest różnica lub siła związku | Zależna od dziedziny i literatury | Im mniejszy efekt, tym większe N |
| Rodzaj testu | Porównanie grup, korelacja, regresja | Wynika z pytania badawczego | Modele wielozmiennowe wymagają więcej |
Wartości 0,05 i 0,80 są konwencjami dyscyplinarnymi, a nie prawami natury. Jeżeli je przyjmujesz, napisz w pracy, że są konwencją — komisja nagradza świadomość tej różnicy.
Najtrudniejszy jest trzeci parametr. Wielkości efektu nie wymyśla się — wyprowadza się ją z literatury, z wcześniejszych badań na podobnej populacji, albo z badania pilotażowego. Dopiero gdy naprawdę nie ma żadnej przesłanki, przyjmuje się efekt umiarkowany i pisze się wprost, że taka była podstawa.
Jak policzyć to w G*Power
G*Power to bezpłatny program analizy mocy rozwijany na Uniwersytecie Heinricha Heinego w Düsseldorfie, dostępny na Windows i macOS. Jest standardem cytowanym w pracach empirycznych w psychologii, pedagogice, naukach o zdrowiu i zarządzaniu.
Procedura ma pięć kroków i zajmuje dosłownie kilka minut:
- Wybierz rodzinę testów (Test family) — na przykład testy t, testy F albo testy dokładne, zgodnie z planowaną analizą.
- Wybierz konkretny test (Statistical test) — porównanie dwóch grup niezależnych, analiza wariancji, korelacja, regresja wieloraka.
- Ustaw typ analizy (Type of power analysis) na A priori: Compute required sample size. To jest krok, który decyduje — analiza post hoc, licząca moc po zebraniu danych, odpowiada na inne pytanie i nie zastępuje planowania.
- Wpisz parametry wejściowe: wielkość efektu, α, moc, a przy porównaniach grup także proporcję ich liczebności.
- Kliknij Calculate i odczytaj Total sample size.
Program pozwala też wygenerować wykres zależności między mocą a liczebnością. Ten wykres, wklejony do aneksu, jest jednym z najtańszych sposobów pokazania, że planowanie badania było świadome.
Cytując G*Power, powołaj się na artykuł źródłowy: Faul, F., Erdfelder, E., Lang, A.-G. i Buchner, A. (2007), G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences, „Behavior Research Methods”, DOI: 10.3758/BF03193146. Dla testów korelacji i regresji właściwe jest uzupełnienie: Faul, F., Erdfelder, E., Buchner, A. i Lang, A.-G. (2009), DOI: 10.3758/BRM.41.4.1149.
Wariant drugi: badanie ankietowe na populacji o znanej wielkości
Jeżeli nie testujesz hipotez, tylko szacujesz odsetek w populacji — na przykład „jaki procent studentów Twojej uczelni korzysta z biblioteki” — nie potrzebujesz analizy mocy, tylko wzoru na wielkość próby przy szacowaniu proporcji. Wchodzą do niego trzy wielkości: poziom ufności (zwykle 95%), zakładany maksymalny błąd oszacowania oraz wielkość populacji. Sam kwestionariusz, z którego te odpowiedzi będą pochodzić, buduje się osobno — procedurę opisujemy w poradniku o tym, jak przygotować ankietę do pracy dyplomowej.
Trzy własności tego wzoru warto znać, zanim usiądziesz do liczenia.
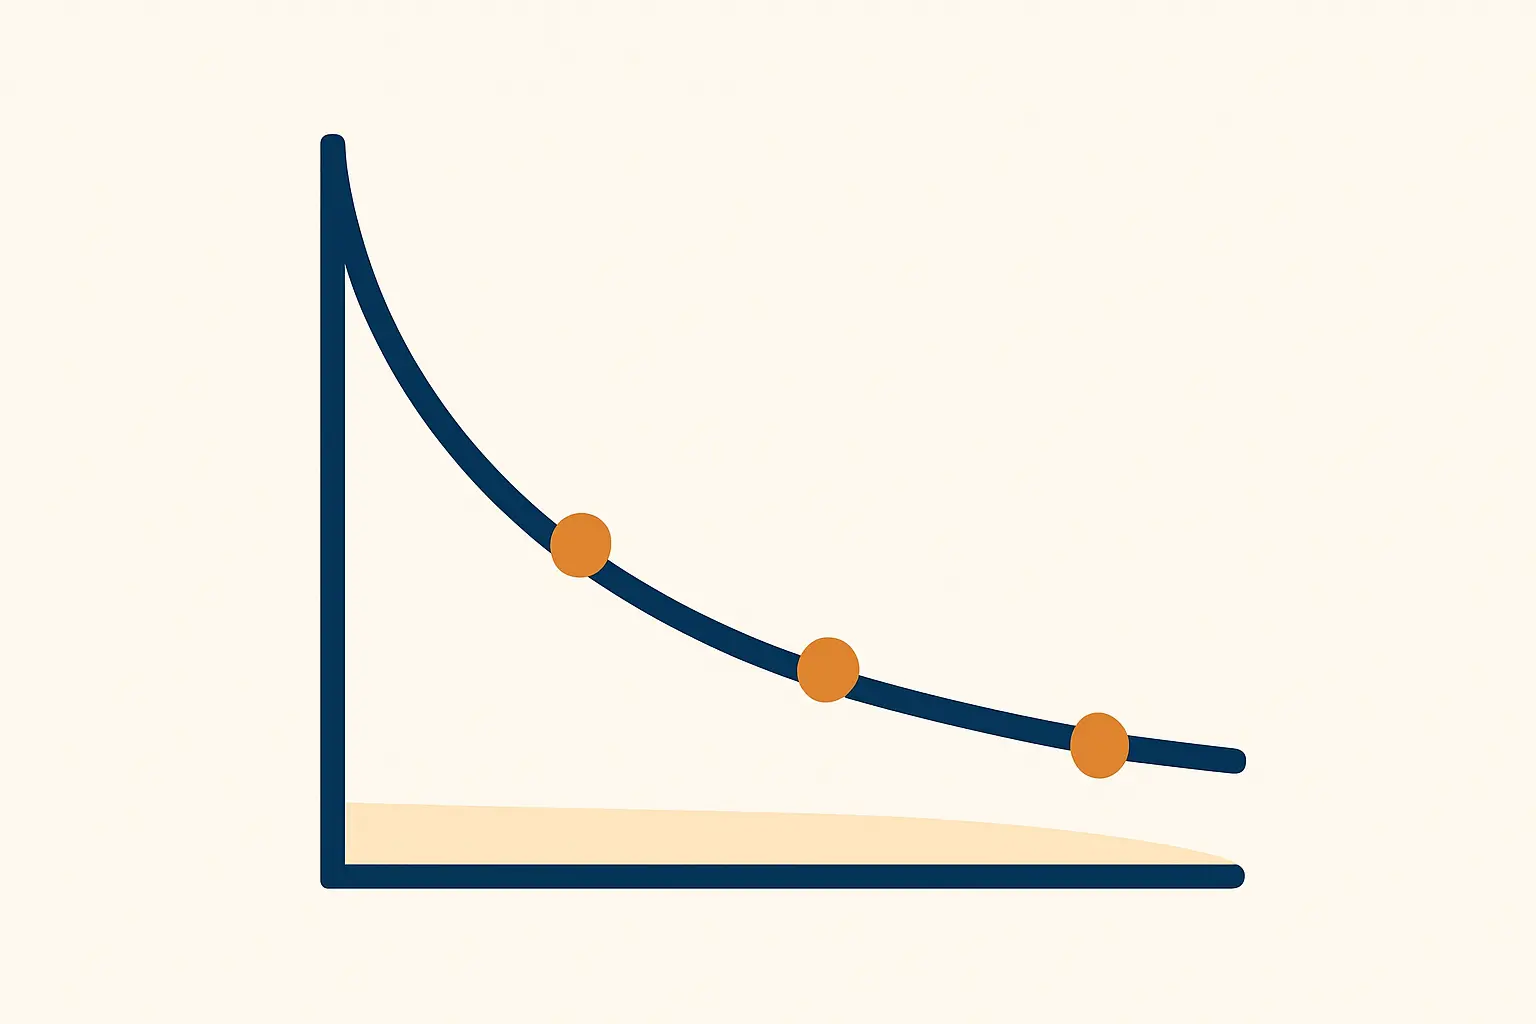
Błąd maleje z pierwiastkiem z N. Żeby zmniejszyć błąd o połowę, musisz mieć czterokrotnie większą próbę. Dlatego przeskok z 400 do 800 respondentów daje dużo mniej, niż intuicja podpowiada.
Wielkość populacji przestaje mieć znaczenie. Przy dużych populacjach wymagane N niemal się nie zmienia — próba potrzebna do zbadania miasta i do zbadania kraju jest podobna. To zaskakuje, ale wynika wprost ze wzoru.
Najostrożniejsze założenie to proporcja 50%. Przy szacowaniu odsetka największą wymaganą próbę daje założenie, że wynik wyniesie połowę. Jeżeli nie wiesz, czego się spodziewać, przyjmij tę wartość i napisz, że to założenie konserwatywne.
Ile osób realnie akceptuje promotor
Tu potrzebna jest szczerość: żaden ogólnopolski przepis nie ustala minimalnej liczebności próby w pracy dyplomowej. Ustawa Prawo o szkolnictwie wyższym i nauce mówi jedynie, że praca jest samodzielnym opracowaniem określonego zagadnienia. Wszelkie progi są zwyczajem wydziałowym albo wymaganiem konkretnego promotora.
Z tego wynikają trzy praktyczne wnioski, które są warte więcej niż jakakolwiek zmyślona liczba.
Po pierwsze, zapytaj promotora wprost i wcześnie, najlepiej razem z pytaniem o metodę. Po drugie, zajrzyj do obronionych prac na swoim kierunku — jeżeli uczelnia udostępnia je w repozytorium, zobaczysz realny standard, a nie wyobrażenie. Po trzecie, obliczona liczba jest zawsze silniejszym argumentem niż liczba zwyczajowa: zdanie „minimalna liczebność wyniosła N przy założeniu efektu umiarkowanego, mocy 0,80 i α = 0,05” zamyka dyskusję, której nie zamknie „zebrałem 100 ankiet, bo tyle się zwykle zbiera”.
Jak zapisać to w rozdziale metodologicznym
Uzasadnienie liczebności to jeden akapit w opisie doboru próby. Wzór do zaadaptowania:
Minimalną liczebność próby ustalono w programie G*Power 3.1 na podstawie analizy a priori dla [nazwa testu], przyjmując poziom istotności α = 0,05, moc testu 1 − β = 0,80 oraz wielkość efektu [wartość] przyjętą na podstawie [źródło: badanie X / badanie pilotażowe / konwencja dla efektu umiarkowanego]. Wymagana liczebność wyniosła N = [liczba]. Ostatecznie w badaniu wzięło udział [liczba] osób, co [spełnia / nie spełnia] to kryterium; konsekwencje omówiono w podrozdziale o ograniczeniach badania.
Zdanie ostatnie jest najważniejsze i najczęściej pomijane. Jeżeli zebrałeś mniej, niż wymagał rachunek, nie ukrywaj tego — nazwij. Praca, która przyznaje ograniczoną moc i wyciąga z tego wniosek („wyniki nieistotne mogą wynikać z niedostatecznej mocy, a nie z braku efektu”), jest oceniana wyżej niż praca udająca, że problemu nie ma.
Pełną strukturę tego rozdziału, wraz z kolejnością pozostałych elementów, rozkładamy w poradniku o tym, jak napisać rozdział metodologiczny, a wybór samego testu — od którego zależy rodzina testów w G*Power — w tekście o tym, jak wybrać test statystyczny.
Cztery najczęstsze błędy
- Liczenie mocy po fakcie. Analiza post hoc na podstawie uzyskanego wyniku nie mówi nic nowego i bywa krytykowana jako mylące uzasadnienie. Analizę robi się przed badaniem.
- Mylenie liczby rozdanych ankiet z liczebnością próby. W N liczą się kompletne, ważne odpowiedzi. Zaplanuj zapas na odrzucenia.
- Przenoszenie N między projektami. Liczebność wystarczająca do porównania dwóch grup nie wystarczy do regresji z pięcioma predyktorami.
- Traktowanie dużej próby jako dowodu jakości. Tysiąc odpowiedzi zebranych metodą kuli śnieżnej wśród znajomych nie jest lepsze od dwustu z doboru losowego — o wnioskowaniu decyduje sposób doboru, nie sama liczba.
A co z badaniem jakościowym?
W badaniach jakościowych nie liczy się liczebności — uzasadnia się nasycenie, czyli moment, w którym kolejne wywiady przestają wnosić nowe kategorie. Uzasadnienie ma inną formę: opisujesz, po którym wywiadzie nowe wątki przestały się pojawiać, i na jakiej podstawie to stwierdziłeś.
Nie mieszaj obu logik w jednej pracy. Jeżeli projekt jest mieszany, uzasadniasz obie części osobno, każdą we właściwej dla niej konwencji.
Metodologia i ograniczenia tego zestawienia
Wartości α = 0,05 i mocy 0,80 podajemy jako konwencje szeroko przyjęte w naukach społecznych i o zdrowiu, a nie jako normy. Nie podajemy tabel „gotowych N” dla poszczególnych testów, ponieważ każda taka tabela wymaga przyjęcia konkretnej wielkości efektu — a to jest decyzja, którą musisz wyprowadzić z własnej literatury, nie przepisać z artykułu w internecie. Nie przytaczamy też żadnego ogólnopolskiego minimum liczebności dla prac dyplomowych, ponieważ takie minimum nie istnieje w przepisach; wszystkie progi mają charakter zwyczaju wydziałowego i należy je zweryfikować u promotora oraz w regulaminie dyplomowania własnej uczelni.
Kiedy masz już obliczone N i zebrane dane, pozostaje zamienić je w rozdział — Tesify utrzymuje strukturę rozdziałów, pilnuje spójności terminów i tego, żeby każda liczba w tekście miała swoje źródło. Zacznij pisać część empiryczną w Tesify.
Najczęstsze pytania
Ile osób musi wziąć udział w badaniu do pracy licencjackiej?
Nie ma przepisu, który by to określał. Liczbę wyprowadza się z analizy mocy dla planowanego testu albo ze wzoru na szacowanie proporcji, a próg zwyczajowy sprawdza się u promotora i w obronionych pracach na kierunku.
Czy 100 ankiet wystarczy na licencjat?
Zależy od tego, co chcesz wykryć. Przy dużym efekcie i porównaniu dwóch grup może wystarczyć mniej; przy małym efekcie albo regresji z kilkoma predyktorami będzie zdecydowanie za mało. Policz zamiast zgadywać.
Czym różni się analiza a priori od post hoc?
A priori liczy wymagane N przed badaniem, przy zadanej mocy. Post hoc liczy moc już po zebraniu danych i nie zastępuje planowania — bywa wręcz krytykowana jako uzasadnienie.
Skąd wziąć wielkość efektu, jeśli nikt tego wcześniej nie badał?
Kolejno: z badań na pokrewnym zjawisku, z własnego pilotażu, a w ostateczności z konwencji dla efektu umiarkowanego — z wyraźnym zaznaczeniem w tekście, że taka była podstawa.
Czy G*Power jest darmowy?
Tak, program jest udostępniany bezpłatnie przez Uniwersytet Heinricha Heinego w Düsseldorfie, w wersjach na Windows i macOS.
Czy większa próba zawsze jest lepsza?
Nie. Po przekroczeniu wymaganego N korzyść z kolejnych obserwacji szybko maleje, bo błąd zmniejsza się z pierwiastkiem z liczebności. Sposób doboru ma większe znaczenie niż sama liczba.
Co, jeśli nie udało mi się zebrać obliczonej liczby?
Opisz to wprost w ograniczeniach: podaj wymagane N, uzyskane N i konsekwencję, czyli obniżoną moc wykrycia efektu. To jest poprawna praktyka, a nie przyznanie się do porażki.
Czy wielkość populacji wpływa na wymaganą próbę?
Przy małych populacjach tak, przy dużych praktycznie przestaje. Dlatego próba potrzebna do zbadania jednego wydziału i całego kraju bywa zbliżona.
Ile wywiadów wystarczy w badaniu jakościowym?
Tam nie liczy się liczebności, tylko uzasadnia nasycenie — moment, w którym kolejne wywiady przestają wnosić nowe kategorie. To osobna procedura i osobny sposób opisu.
Czy muszę cytować program, w którym liczyłem?
Tak, to standard w pracach empirycznych. W przypadku G*Power podaje się artykuł źródłowy Faula i współautorów, najlepiej z numerem DOI.